當人工智能能參與製作精美的匯報或書面分析,成品本身便較難充分說明誰理解背後的推理。這才是我希望在動作科學處理的評估問題,而不只是學習者可能使用人工智能。
我沒有禁止在準備階段使用人工智能。它可以協助構思、組織想法、提出其他解釋、改善表達、批判初步說法,以及找出需要查證的問題。然而,準確性、證據與最終論證的責任仍在人。
我關心的不是人工智能有否參與製作匯報,而是匯報者能否解釋、質疑並捍衛背後的推理。
改變了甚麼
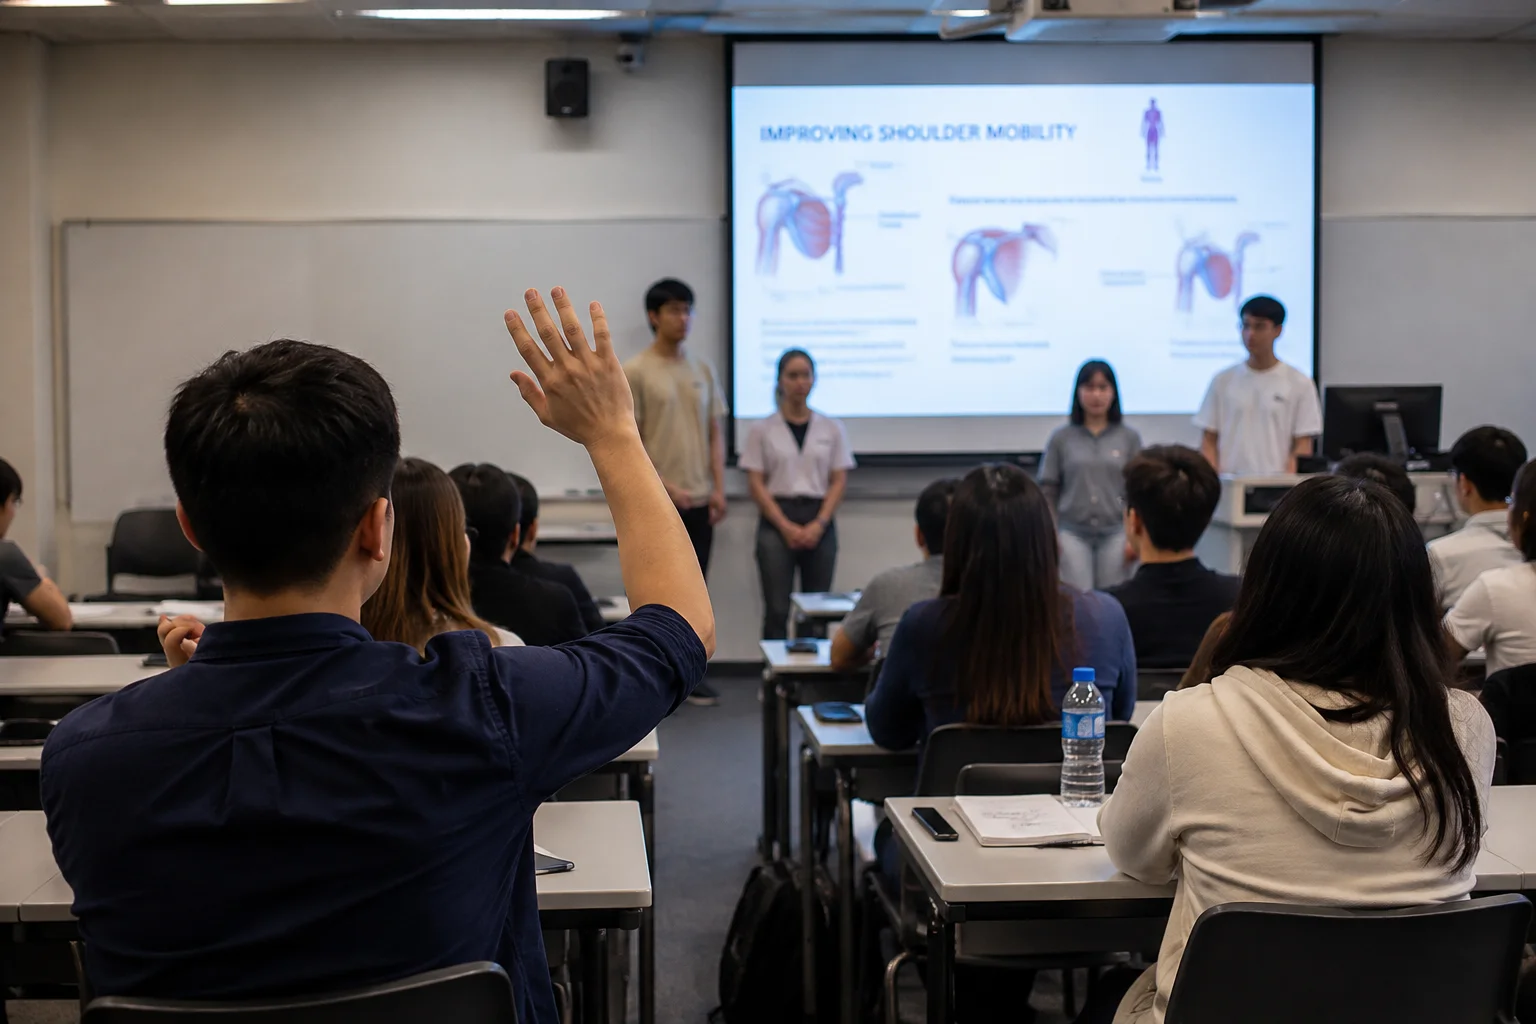
評估保留協作的動作分析項目與小組匯報。重要的發展,是在匯報後加入結構化、隨機抽選答辯者的小組口頭答辯。任何組員都可能就整份分析的任何實質部分被提問,不論是否由該組員準備或匯報。
- 人工智能支援準備:小組在任務訂明的使用範圍內建立動作分析,並對來源查證、生物力學詮釋、證據及最終判斷負責。
- 協作建構:組員共同準備分析,檢視解釋與建議是否連貫。提交的是共同作品,而非互不相連的分工片段。
- 小組匯報:小組呈現動作分析與建議。
- 結構化隨機小組答辯:評核者隨機抽選回答者。問題可涉及整份分析的解釋、理據、證據、詮釋、限制或應用;回答者不一定是負責該部分的匯報者。
- 個人責任與人類判斷:口頭回答為共同作品以外的個人理解提供額外證據。評核者按評估準則詮釋證據,人工智能不作學術判斷。
人工智能支援準備 → 協作分析 → 小組匯報 → 結構化隨機小組答辯 → 個人責任 → 人類判斷
簡言之:準備 → 協作 → 匯報 → 就任何部分答辯 → 提出理據。人工智能可以協助製作作品,小組須對作品負責;答辯補充有關負責者理解程度的證據。
為何隨機抽選回答者
小組工作可能演變成單純分工:每人只熟悉自己的一部分,沒有人能解釋整體論證。如果問題只交給準備該部分的人,這種割裂便可能繼續存在。
當每位組員知道任何部分都可能成為自己的問題,把作業分割成互不相連的片段便不再是穩妥策略。這項設計旨在讓組員有理由互相教導、檢視概念之間的連結,並準備自己投影片以外的內容。
設計旨在把個人責任融入協作任務,讓組員有理由互相協助,理解整份分析。
這項設計以甚麼為依據
AIAS:為何人工智能仍可使用
人工智能評估量表(AIAS)提供一種方法,讓容許的人工智能使用與學習成果及評估目的對齊(Furze 等,2024;Perkins 等,2025)。它並不代表所有用法都應獲准;只替原有作業加上標籤,也不等於重新設計。
對這項任務而言,禁止人工智能本身並非學習成果。準備時可以使用人工智能,同時要求學習者查證主張、理解生物力學,並對論證負責。框架幫助我說明容許的支援與預期理解之間的關係。
評估效度:為何成品不再足夠
Dawson 等(2024)主張關注效度,而非把遵守規則視為評估的終點。在人工智能普及的環境,我需要問:現有證據能否支持我對學習者推理所作的推論?
問題因此由人工智能偵測,轉為評估效度:甚麼證據讓我能對作品背後的推理作出有理據的判斷?匯報與現場答辯提供不同證據;兩者結合,為評核者提供更廣闊的判斷基礎。
社會互賴與個人責任
社會互賴理論提供理解協作設計的視角。合作學習文獻把正向互賴與個人責任結合:組員朝共同成果努力,每人仍須展示學習(Johnson 與 Johnson,1999)。小組匯報提供共同作品,答辯則在共同作品之內引入個人責任。
Sarfo 與 Elen(2011)研究準備及責任安排,包括小組活動後隨機抽選接受考核。相關之處在於鼓勵共同準備,同時保留個人責任。我的設計並沒有採用由被抽選者的回答決定共同分數的安排。
這個理論視角說明為何保留協作,同時要求理解超越個人分工;亦提醒我們,分配不同內容給組員不會自動產生共同理解。
自我解釋:為何說明推理重要
Chi 等(1994)探討如何透過引導學習者產生解釋,支持新資訊與已有知識的整合。要求說明某個生物力學詮釋或建議為何合理,在概念上與這個方向一致。
答辯與 Chi 等人研究的學習介入不同,但該研究有助說明:產生解釋的價值,超越單純給出答案。
評價判斷:為何仍須審視人工智能支援的作品
Bearman 等(2024)討論使用生成式人工智能時判斷質素的重要性。流暢的動作科學答案仍須接受檢視:解釋可信嗎?證據支持嗎?生物力學詮釋站得住腳嗎?
學習者須決定保留、修改或捨棄甚麼。答辯可以要求他們說明決定及承認不確定性。重點由產生看似合理的答案,轉為對答案的質素負責。
隨機不等於隨意
最有力的設計,是回答者難以預測,但學習範疇、預期標準與評分準則可以預知。隨機性決定誰回答,不應決定回答者面對甚麼學術標準。
傳統非結構化口試的難度、評核者做法及涵蓋內容可能不一致。評核者準備與結構化口試研究提醒我們重視這些條件(Joseph 等,2022;Loomba 與 Jindal,2024)。
設計原則包括:
- 預先界定範疇,對應預期學習成果與評估準則,包括生物力學推理、證據、詮釋及應用。
- 不同小組的問題應具有相若要求,並可追問解釋、理據及限制。
- 使用共同評分準則,預先說明形式與標準,並讓評核者準備一致地詮釋回答。
- 提供口頭解釋的練習機會,保留合理的無障礙調整;語速或自信不應取代所評估的推理。
- 檢視每人的問題涵蓋範圍與證據份量;少量隨機抽樣不能保證全面評估。
實務上的工作,是把這些原則轉化為一致的問題、計分及無障礙安排。隨機抽選只是其中一部分。
是證據策略,不是人工智能偵測
人工智能已在指定範圍內獲准使用,答辯並非為了辨認是否用過人工智能,而是收集理解、推理與責任的另一種證據。
近期研究更直接探討相關方法。Hutson 等(2026)試行 Integrevise™,把提交的作品與簡短的適應性口頭答辯結合,讓學習者解釋推理與應用。研究指出,清晰的期望、實施方式及學習者對答辯目的的理解都很重要,而非單純加入口試。這項平台試行提供相關例子,並非對我這項由教師主持的小組答辯的測試。
核心問題不再是人工智能有否協助製作匯報,而是:任何一位組員被抽選時,能否解釋、提出理據並捍衛共同提交的分析?人工智能可以協助作品,卻不能代替小組承擔理解的責任。
答辯刻意重新連結作品與負責者。
我較關心的不是讓評估「人工智能無法完成」,而是確保使用人工智能不會令人類理解變成可有可無。
仍須評估的地方
這些框架解釋我的設計選擇,但不能確立本評估的效果。我仍須檢視題目等同性、評核者一致性、無障礙安排及個人回答的涵蓋程度,以及設計會否促進共同準備,還是只帶來策略性排練。學習、臨床能力、公平性或可靠性的改善,均須經評估才可判斷。
未預先見過的知識遷移任務,或可補充應用於準備範例以外的證據;它仍是下一階段的建議,並非本文已實施或評估的部分。
目標是在人工智能普及的環境設計評估:協作仍有價值,人工智能仍可支援準備,而人類推理仍不可或缺。
參考文獻
Bearman, M., Tai, J., Dawson, P., Boud, D., & Ajjawi, R. (2024). Developing evaluative judgement for a time of generative artificial intelligence. Assessment & Evaluation in Higher Education, 49(6), 893–905. https://doi.org/10.1080/02602938.2024.2335321
Chi, M. T. H., De Leeuw, N., Chiu, M.-H., & Lavancher, C. (1994). Eliciting self-explanations improves understanding. Cognitive Science, 18(3), 439–477. https://doi.org/10.1207/s15516709cog1803_3
Dawson, P., Bearman, M., Dollinger, M., & Boud, D. (2024). Validity matters more than cheating. Assessment & Evaluation in Higher Education, 49(7), 1005–1016. https://doi.org/10.1080/02602938.2024.2386662
Furze, L., Perkins, M., Roe, J., & MacVaugh, J. (2024). The AI Assessment Scale (AIAS) in action: A pilot implementation of GenAI-supported assessment. Australasian Journal of Educational Technology, 40(4), 38–55. https://doi.org/10.14742/ajet.9434
Johnson, D. W., & Johnson, R. T. (1999). Making cooperative learning work. Theory Into Practice, 38(2), 67–73. https://doi.org/10.1080/00405849909543834
Joseph, N., Rai, S., Singh, V. P., Karnad, S. D., & Kadur, K. (2022). Effectiveness of an Online Viva Voce Workshop in Improving the Knowledge of Faculties of Various Health Science Courses in Mangalore, India. Education and Self Development, 17(2), 9–25. https://doi.org/10.26907/esd.17.2.04
Loomba, R., & Jindal, N. M. (2024). Improving process aspect of oral examination as assessment tool in undergraduate biochemistry by introducing structured oral examination: an observational study in India based on a survey among stakeholders. Korean Journal of Medical Education, 36(4), 367–377. https://doi.org/10.3946/kjme.2024.310
Perkins, M., Roe, J., & Furze, L. (2025). How (not) to use the AI Assessment Scale. Journal of Applied Learning & Teaching, 8(2), 14–23. https://doi.org/10.37074/jalt.2025.8.2.15
Sarfo, F. K., & Elen, J. (2011). Investigating the impact of positive resource interdependence and individual accountability on students’ academic performance in cooperative learning. Electronic Journal of Research in Educational Psychology, 9(1), 73–94. https://doi.org/10.25115/ejrep.v9i23.1428
Hutson, J., Poyer, K., Ogoe, E., & Atologun, K. A. (2026). Beyond AI Detection: A Pilot Study of Integrevise™ and Viva-Based Verification of Student Understanding in AI-Mediated Assessment. Trends in Higher Education, 5(3), 59. https://doi.org/10.3390/higheredu5030059