当人工智能能参与制作精美的汇报或书面分析,成品本身便较难充分说明谁理解背后的推理。这才是我希望在动作科学处理的评估问题,而不只是学习者可能使用人工智能。
我没有禁止在准备阶段使用人工智能。它可以帮助构思、组织想法、提出其他解释、改善表达、批判初步说法,以及找出需要查证的问题。然而,准确性、证据与最终论证的责任仍在人。
我关心的不是人工智能有否参与制作汇报,而是汇报者能否解释、质疑并捍卫背后的推理。
改变了什么
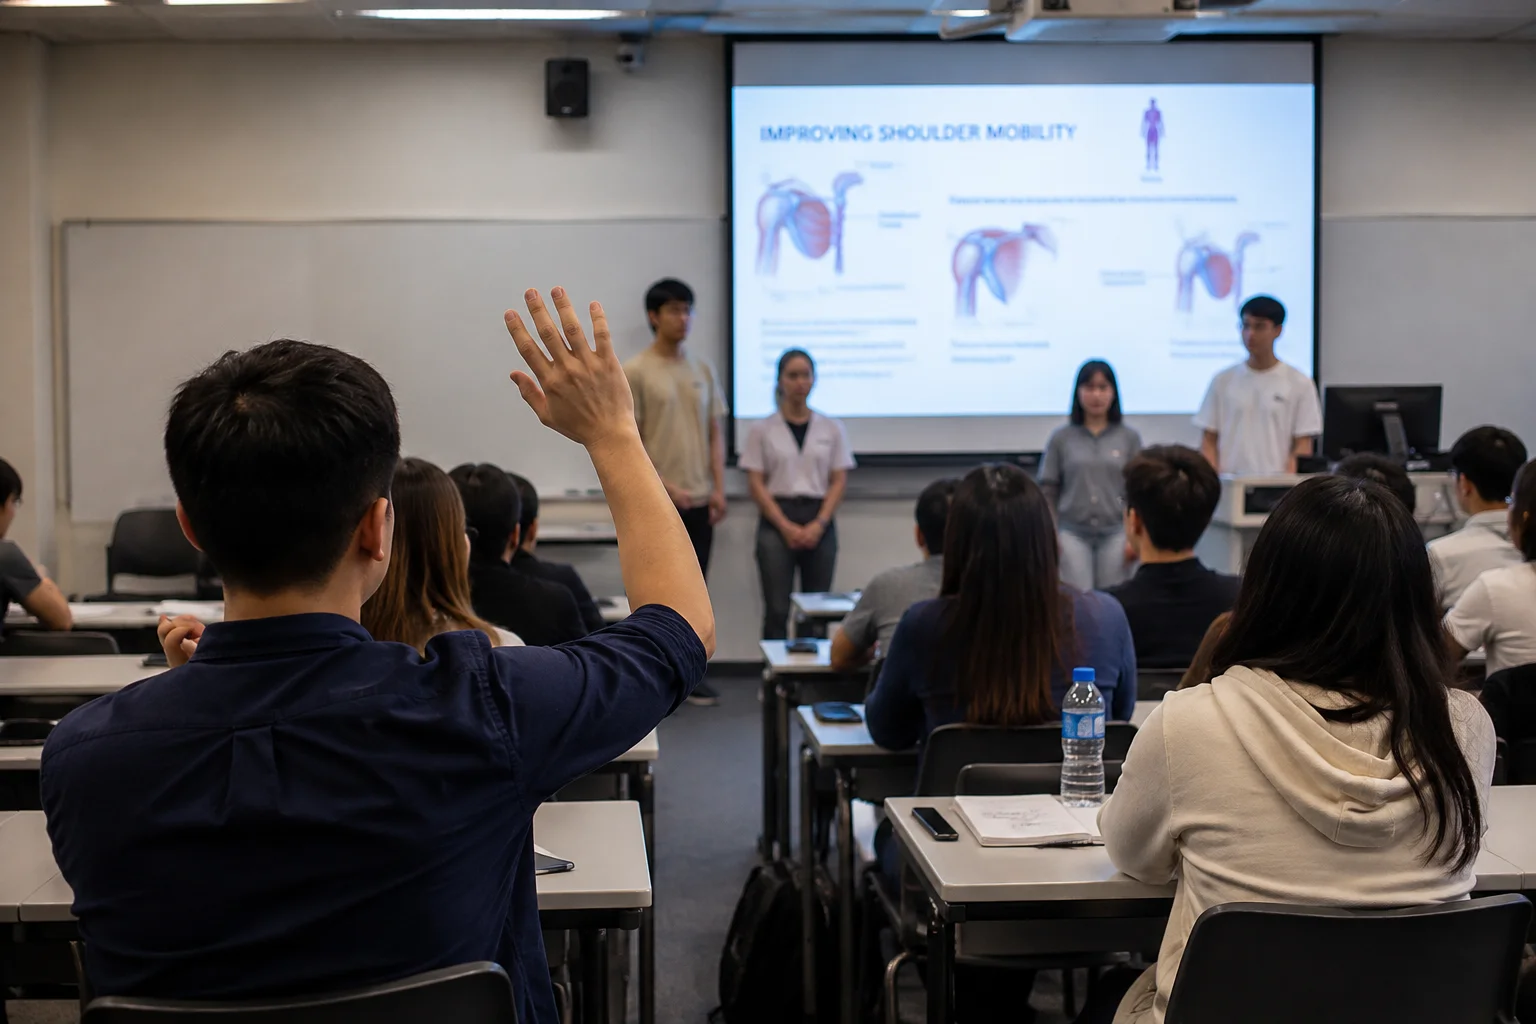
评估保留协作的动作分析项目与小组汇报。重要的发展,是在汇报后加入结构化、随机抽选答辩者的小组口头答辩。任何组员都可能就整份分析的任何实质部分被提问,不论是否由该组员准备或汇报。
- 人工智能支持准备:小组在任务订明的使用范围内建立动作分析,并对来源查证、生物力学诠释、证据及最终判断负责。
- 协作建构:组员共同准备分析,检视解释与建议是否连贯。提交的是共同作品,而非互不相连的分工片段。
- 小组汇报:小组呈现动作分析与建议。
- 结构化随机小组答辩:评核者随机抽选回答者。问题可涉及整份分析的解释、理据、证据、诠释、限制或应用;回答者不一定是负责该部分的汇报者。
- 个人责任与人类判断:口头回答为共同作品以外的个人理解提供额外证据。评核者按评估准则诠释证据,人工智能不作学术判断。
人工智能支持准备 → 协作分析 → 小组汇报 → 结构化随机小组答辩 → 个人责任 → 人类判断
简言之:准备 → 协作 → 汇报 → 就任何部分答辩 → 提出理据。人工智能可以帮助制作作品,小组须对作品负责;答辩补充有关负责者理解程度的证据。
为何随机抽选回答者
小组工作可能演变成单纯分工:每人只熟悉自己的一部分,没有人能解释整体论证。如果问题只交给准备该部分的人,这种割裂便可能继续存在。
当每位组员知道任何部分都可能成为自己的问题,把作业分割成互不相连的片段便不再是稳妥策略。这项设计旨在让组员有理由互相教导、检视概念之间的联系,并准备自己幻灯片以外的内容。
设计旨在把个人责任融入协作任务,让组员有理由互相帮助,理解整份分析。
这项设计以什么为依据
AIAS:为何人工智能仍可使用
人工智能评估量表(AIAS)提供一种方法,让允许的人工智能使用与学习成果及评估目的对齐(Furze 等,2024;Perkins 等,2025)。它并不代表所有用法都应获准;只替原有作业加上标签,也不等于重新设计。
对这项任务而言,禁止人工智能本身并非学习成果。准备时可以使用人工智能,同时要求学习者查证主张、理解生物力学,并对论证负责。框架帮助我说明允许的支持与预期理解之间的关系。
评估效度:为何成品不再足够
Dawson 等(2024)主张关注效度,而非把遵守规则视为评估的终点。在人工智能普及的环境,我需要问:现有证据能否支持我对学习者推理所作的推论?
问题因此由人工智能检测,转为评估效度:什么证据让我能对作品背后的推理作出有理据的判断?汇报与现场答辩提供不同证据;两者结合,为评核者提供更广阔的判断基础。
社会互赖与个人责任
社会互赖理论提供理解协作设计的视角。合作学习文献把正向互赖与个人责任结合:组员朝共同成果努力,每人仍须展示学习(Johnson 与 Johnson,1999)。小组汇报提供共同作品,答辩则在共同作品之内引入个人责任。
Sarfo 与 Elen(2011)研究准备及责任安排,包括小组活动后随机抽选接受考核。相关之处在于鼓励共同准备,同时保留个人责任。我的设计并没有采用由被抽选者的回答决定共同分数的安排。
这个理论视角说明为何保留协作,同时要求理解超越个人分工;也提醒我们,分配不同内容给组员不会自动产生共同理解。
自我解释:为何说明推理重要
Chi 等(1994)探讨如何通过引导学习者产生解释,支持新信息与已有知识的整合。要求说明某个生物力学诠释或建议为何合理,在概念上与这个方向一致。
答辩与 Chi 等人研究的学习干预不同,但该研究有助说明:产生解释的价值,超越单纯给出答案。
评价判断:为何仍须审视人工智能支持的作品
Bearman 等(2024)讨论使用生成式人工智能时判断质量的重要性。流畅的动作科学答案仍须接受检视:解释可信吗?证据支持吗?生物力学诠释站得住脚吗?
学习者须决定保留、修改或舍弃什么。答辩可以要求他们说明决定及承认不确定性。重点由产生看似合理的答案,转为对答案的质量负责。
随机不等于随意
最有力的设计,是回答者难以预测,但学习领域、预期标准与评分准则可以预知。随机性决定谁回答,不应决定回答者面对什么学术标准。
传统非结构化口试的难度、评核者做法及涵盖内容可能不一致。评核者准备与结构化口试研究提醒我们重视这些条件(Joseph 等,2022;Loomba 与 Jindal,2024)。
设计原则包括:
- 预先界定领域,对应预期学习成果与评估准则,包括生物力学推理、证据、诠释及应用。
- 不同小组的问题应具有相若要求,并可追问解释、理据及限制。
- 使用共同评分准则,预先说明形式与标准,并让评核者准备一致地诠释回答。
- 提供口头解释的练习机会,保留合理的无障碍调整;语速或自信不应取代所评估的推理。
- 检视每人的问题涵盖范围与证据份量;少量随机抽样不能保证全面评估。
实践上的工作,是把这些原则转化为一致的问题、计分及无障碍安排。随机抽选只是其中一部分。
是证据策略,不是人工智能检测
人工智能已在指定范围内获准使用,答辩并非为了辨认是否用过人工智能,而是收集理解、推理与责任的另一种证据。
近期研究更直接探讨相关方法。Hutson 等(2026)试行 Integrevise™,把提交的作品与简短的适应性口头答辩结合,让学习者解释推理与应用。研究指出,清晰的期望、实施方式及学习者对答辩目的的理解都很重要,而非单纯加入口试。这项平台试行提供相关例子,并非对我这项由教师主持的小组答辩的测试。
核心问题不再是人工智能有否帮助制作汇报,而是:任何一位组员被抽选时,能否解释、提出理据并捍卫共同提交的分析?人工智能可以帮助作品,却不能代替小组承担理解的责任。
答辩刻意重新联系作品与负责者。
我较关心的不是让评估“人工智能无法完成”,而是确保使用人工智能不会令人类理解变成可有可无。
仍须评估的地方
这些框架解释我的设计选择,但不能确立本评估的效果。我仍须检视题目等同性、评核者一致性、无障碍安排及个人回答的涵盖程度,以及设计会否促进共同准备,还是只带来策略性排练。学习、临床能力、公平性或可靠性的改善,均须经评估才可判断。
未预先见过的知识迁移任务,或可补充应用于准备范例以外的证据;它仍是下一阶段的建议,并非本文已实施或评估的部分。
目标是在人工智能普及的环境设计评估:协作仍有价值,人工智能仍可支持准备,而人类推理仍不可或缺。
参考文献
Bearman, M., Tai, J., Dawson, P., Boud, D., & Ajjawi, R. (2024). Developing evaluative judgement for a time of generative artificial intelligence. Assessment & Evaluation in Higher Education, 49(6), 893–905. https://doi.org/10.1080/02602938.2024.2335321
Chi, M. T. H., De Leeuw, N., Chiu, M.-H., & Lavancher, C. (1994). Eliciting self-explanations improves understanding. Cognitive Science, 18(3), 439–477. https://doi.org/10.1207/s15516709cog1803_3
Dawson, P., Bearman, M., Dollinger, M., & Boud, D. (2024). Validity matters more than cheating. Assessment & Evaluation in Higher Education, 49(7), 1005–1016. https://doi.org/10.1080/02602938.2024.2386662
Furze, L., Perkins, M., Roe, J., & MacVaugh, J. (2024). The AI Assessment Scale (AIAS) in action: A pilot implementation of GenAI-supported assessment. Australasian Journal of Educational Technology, 40(4), 38–55. https://doi.org/10.14742/ajet.9434
Johnson, D. W., & Johnson, R. T. (1999). Making cooperative learning work. Theory Into Practice, 38(2), 67–73. https://doi.org/10.1080/00405849909543834
Joseph, N., Rai, S., Singh, V. P., Karnad, S. D., & Kadur, K. (2022). Effectiveness of an Online Viva Voce Workshop in Improving the Knowledge of Faculties of Various Health Science Courses in Mangalore, India. Education and Self Development, 17(2), 9–25. https://doi.org/10.26907/esd.17.2.04
Loomba, R., & Jindal, N. M. (2024). Improving process aspect of oral examination as assessment tool in undergraduate biochemistry by introducing structured oral examination: an observational study in India based on a survey among stakeholders. Korean Journal of Medical Education, 36(4), 367–377. https://doi.org/10.3946/kjme.2024.310
Perkins, M., Roe, J., & Furze, L. (2025). How (not) to use the AI Assessment Scale. Journal of Applied Learning & Teaching, 8(2), 14–23. https://doi.org/10.37074/jalt.2025.8.2.15
Sarfo, F. K., & Elen, J. (2011). Investigating the impact of positive resource interdependence and individual accountability on students’ academic performance in cooperative learning. Electronic Journal of Research in Educational Psychology, 9(1), 73–94. https://doi.org/10.25115/ejrep.v9i23.1428
Hutson, J., Poyer, K., Ogoe, E., & Atologun, K. A. (2026). Beyond AI Detection: A Pilot Study of Integrevise™ and Viva-Based Verification of Student Understanding in AI-Mediated Assessment. Trends in Higher Education, 5(3), 59. https://doi.org/10.3390/higheredu5030059