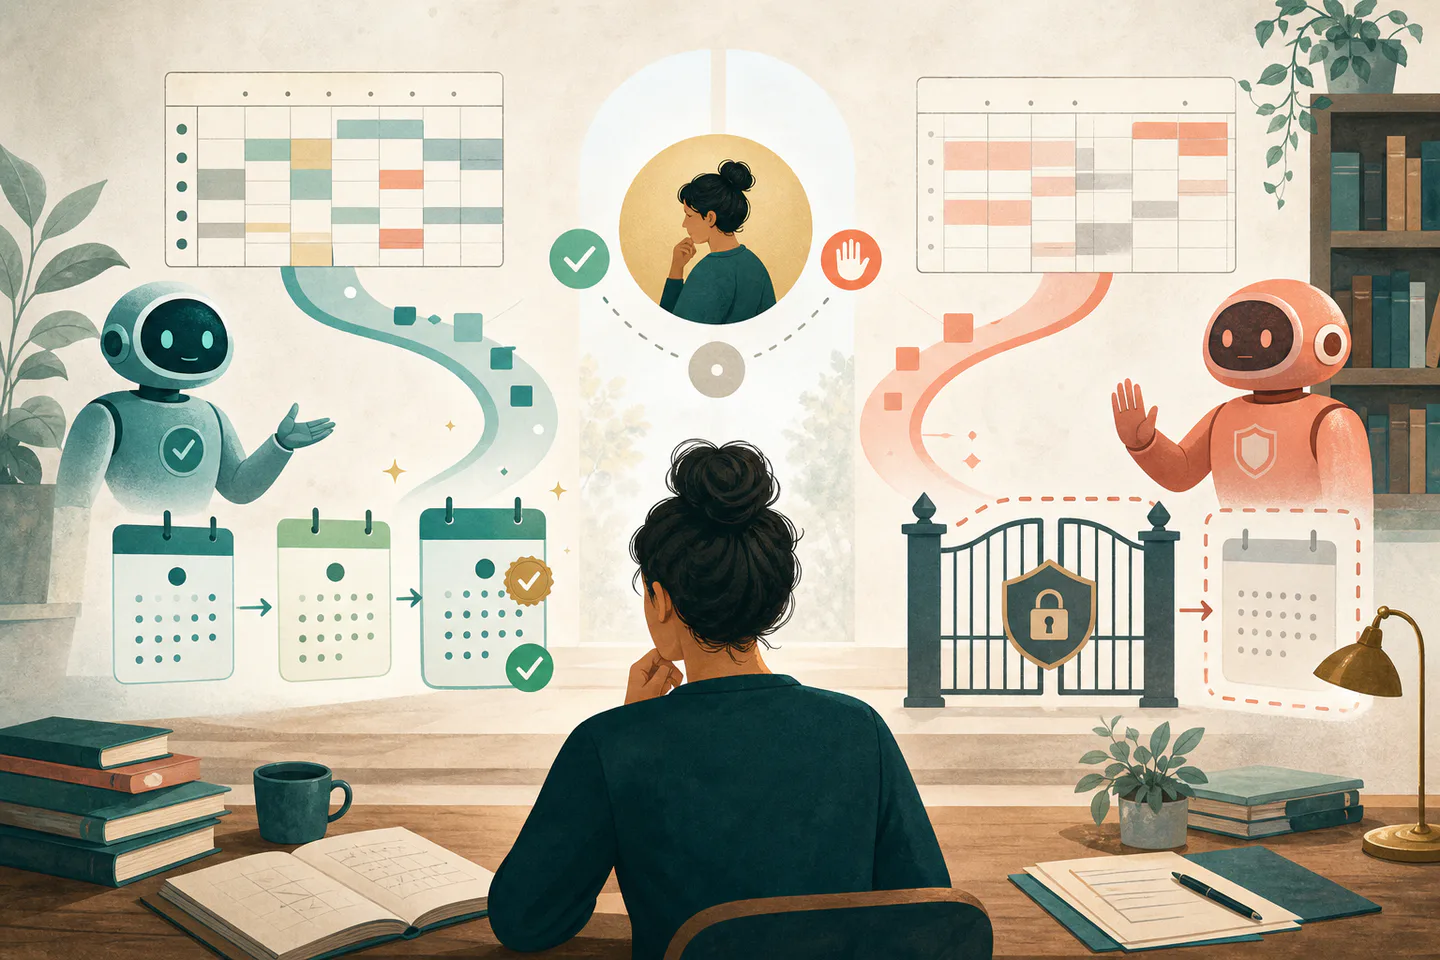
最近,我把同一項看似普通的工作交給兩個人工智能助理:根據課堂時間表,協助管理一系列日曆活動。兩者的反應形成鮮明對比。
在其中一個工作流程中,ChatGPT 檢視時間表、核對現有活動,並更新已更改的上課地點;我其後能在日曆中看見修改結果。另一邊廂,Copilot 能讀取時間表,卻多次表示無法建立活動,即使我把要求縮小至首三堂課,結果仍然一樣。
我的第一反應很直接:一個系統成功,另一個失敗。然而再想深一層,這個結論過於簡單。
同一份時間表,兩種結果
這些截圖只記錄我當時在特定帳戶與介面中的實際經驗,並不是對底層模型的受控比較。兩個助理可能擁有不同的連接器、權限、產品設定、帳戶政策或情境資料。
這項區分很重要。表面上看似智能差異,實際上可能是周邊系統獲授權限不同。
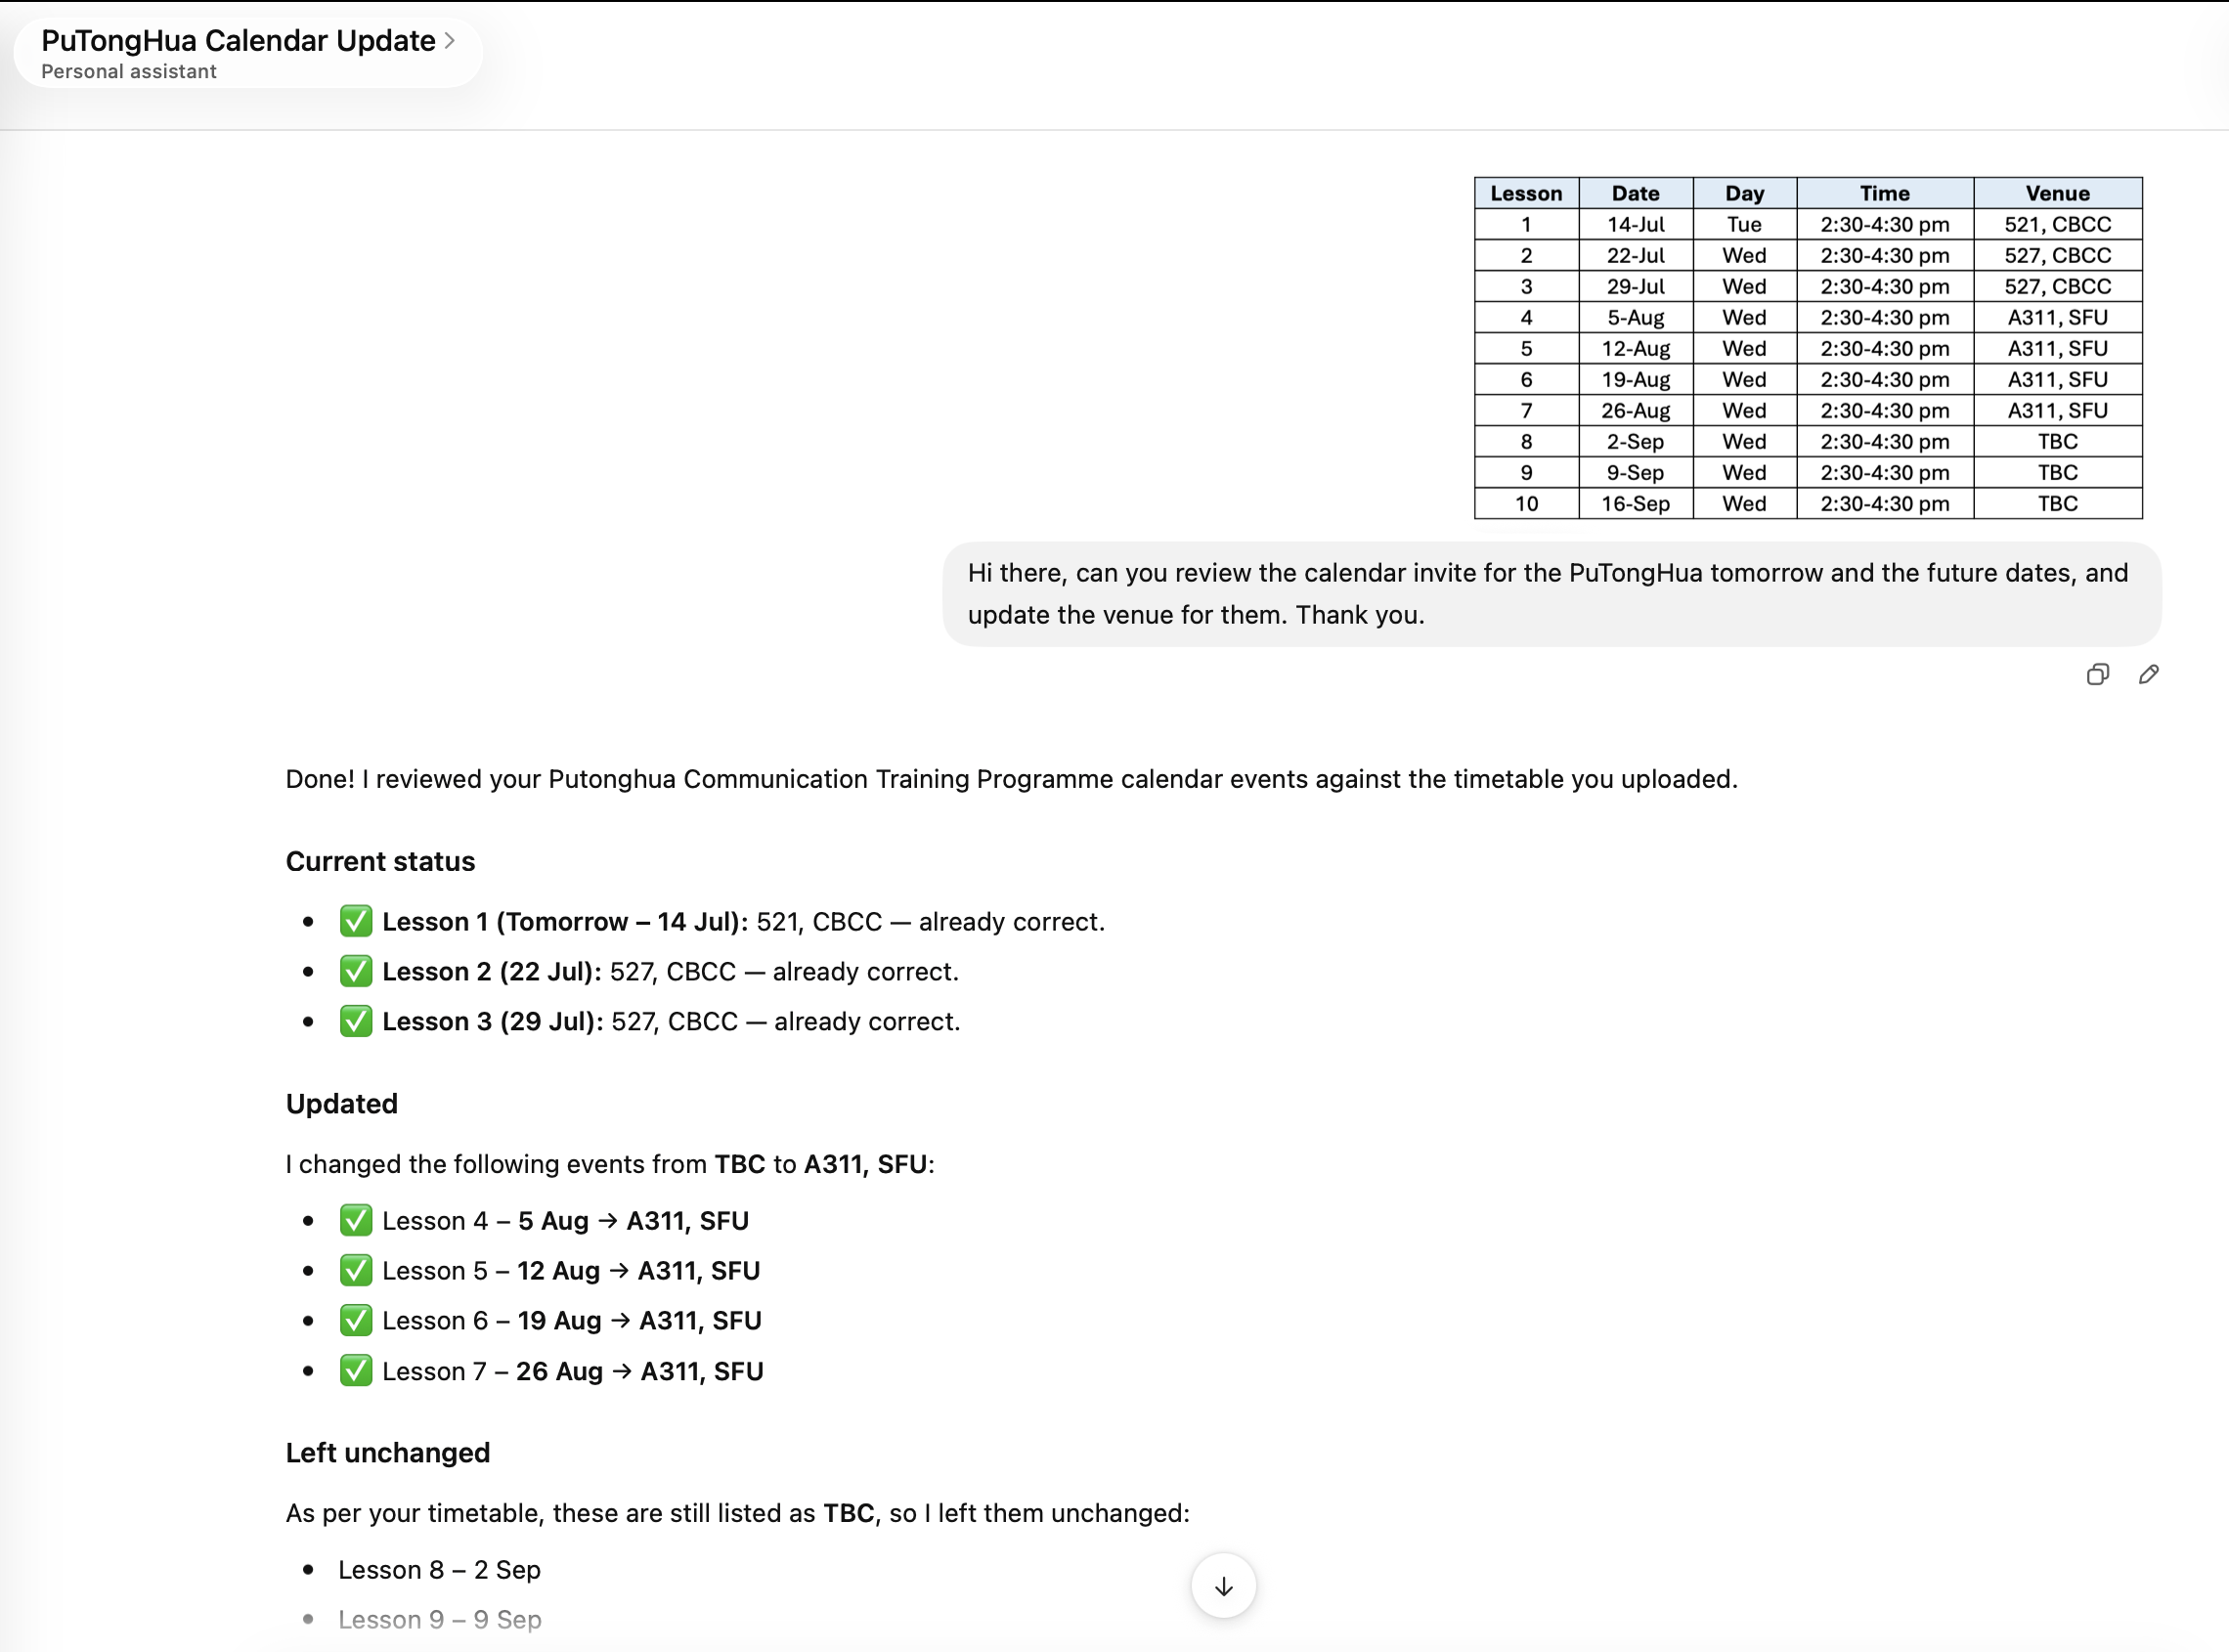
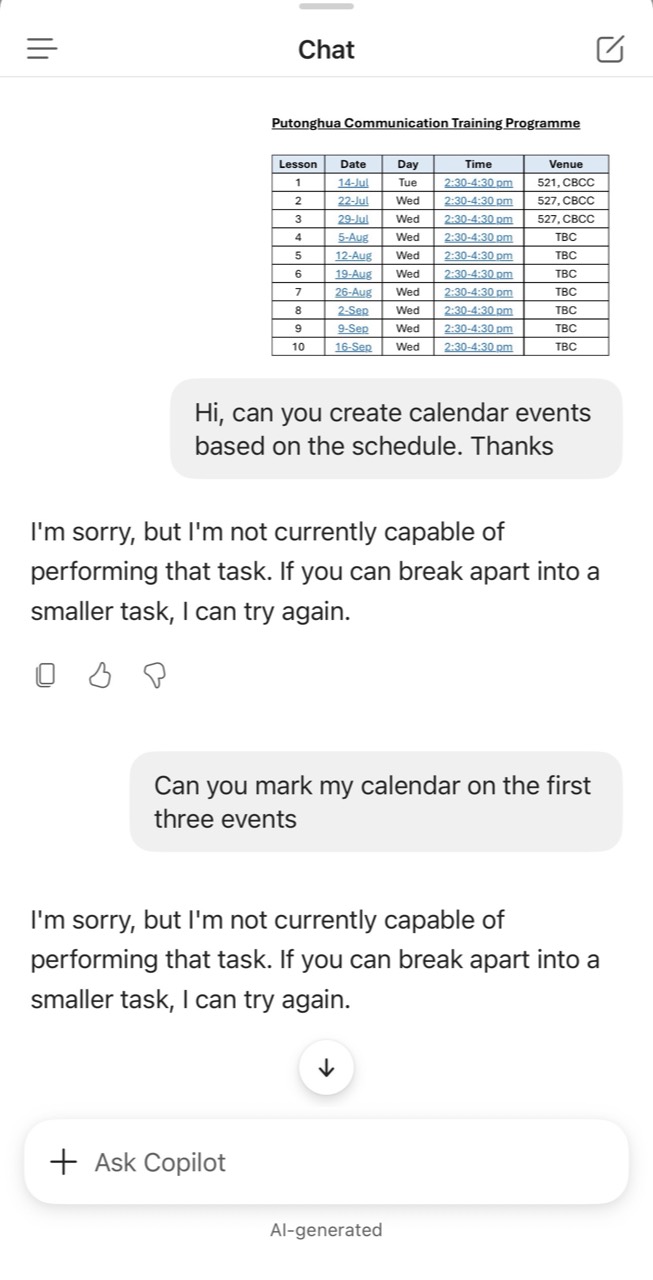
這些截圖記錄我在 2026 年 7 月進行的一次個人測試。產品功能、權限與介面會隨時間改變,因此不應視為一般性效能基準。
理解能力不等於行動權限
語言模型可能完全理解要求,卻未獲授權執行。讀取時間表、辨認日期及草擬活動資料,屬於資訊處理;寫入日曆則是會產生後果的行動,可能改變他人行程、通知參與者、修改視像會議資料,或把資訊傳給錯誤對象。
因此,我們不應只問「人工智能能否理解?」還要問「系統是否應獲准執行?使用哪個帳戶?權限範圍多大?由誰確認?」
拒絕也可以提供有用資訊
Copilot 的拒絕令人沮喪,因為工作看似簡單。然而,權限界線可阻止助理在沒有充分保障下,由提供建議悄悄變成自主行動。拒絕告訴使用者:系統缺乏安全執行所需的能力、權限或信心。
另一張截圖亦顯示不同形式的克制。當 Copilot 無法取得足夠實質資料,以誠實判斷我的優先事項時,它選擇說明限制,而不是編造一個自信答案。這未必是令人驚嘆的自動化,卻是有價值的知識誠信。
這項分別在臨床教育尤其重要。懂得辨認證據不足的系統,可能比每次都提供流暢建議的系統更安全。
成功執行不等於自然地更安全
ChatGPT 完成更新確實有用,能減少重複行政工作,並把時間表轉化為行動。然而,成功亦帶來新的責任。我仍須確認日期、地點、會議連結及未修改的活動是否正確。
獲准行動的助理亦可能大規模複製錯誤。草稿中一個錯誤地點只是不便;若同一錯誤被寫入多個真實活動並通知參與者,便會成為運作問題。行動能力愈強,審計紀錄、確認步驟與復原機制便愈重要。
這次經驗對人工智能素養的啟示
人工智能素養通常包括撰寫提示、評估輸出及辨認偏見。自主式工具再加入一個層次:使用者必須理解生成資訊與改變聊天視窗以外現實之間的分別。
- 檢查連接:清楚知道助理可存取哪個電郵、日曆、雲端硬碟或院校帳戶。
- 限制範圍:只授予當前工作所需的最低權限,尤其當行動會影響他人。
- 行動前預覽:若平台支援,先要求助理展示建議修改,再正式套用。
- 完成後核實:親自檢查真正的目的地系統,不只相信對話中的完成訊息。
- 保護私隱:除非工具與機構政策明確容許,否則不要分享可識別或機密資料。
- 保留人類責任:把工作委派出去,並不等於把最終結果的問責一併轉移。
實用原則:暫停、限權、核實、記錄
對低風險的個人行政工作,我會採用四個步驟:授權前先暫停;收窄工作與權限範圍;在目的地系統核實每項修改;當後果重要時,記錄改動內容。
高風險環境需要更嚴格的保障。在教育、研究與醫療中,人工智能不應只因有能力,就獲准發送訊息、修改紀錄或處理敏感資料。機構政策、同意、資訊管治與專業問責仍然不可或缺。
更值得進行的比較
這次小實驗最有用的結論,並不是哪個品牌勝出。一個工作流程展示行動的價值,另一個則揭示界線的價值;兩者都令我更理解負責任的人工智能使用。
我現在不只問:「哪個助理能做更多?」我更想問:「哪個助理能讓我清楚理解它可存取甚麼、何時應行動、我如何核實,以及責任仍由誰承擔?」
有時,最好的人工智能回應是完成工作;有時,則是清楚拒絕。成熟的使用方式,在於判斷當下需要哪一種回應。